 mediante la desviación típica de las replicaciones. Es decir,
se aplica directamente la definición de error típico (desviación
típica de la distribución muestral de un estadístico)
sobre la distribución muestral bootstrap.
Como ya se ha dicho el bootstrap y otras técnicas de remuestreo surgieron como métodos basados en cálculos intensivos mediante ordenador que permiten ofrecer medidas de la precisión de los estimadores estadísticos. Uno de esos indicadores de precisión en las estimaciones es el Error Típico del estimador.
Para algunos casos como el de la media aritmética existen fórmulas sencillas que nos permiten estimar el valor del error típico. Pero no siempre es este el caso, como ocurre con la mediana o con las medias recortadas, por citar dos estadísticos relativamente simples. La estimación bootstrap del error típico es posible para todos los estimadores y no requiere cálculos teóricos.
El algoritmo bootstrap trabaja extrayendo muchas
muestras bootstrap independientes, calculando en cada una de ellas el correspondiente
estadístico, y estimando el error típico de
mediante la desviación típica de las replicaciones. Es decir,
se aplica directamente la definición de error típico (desviación
típica de la distribución muestral de un estadístico)
sobre la distribución muestral bootstrap.
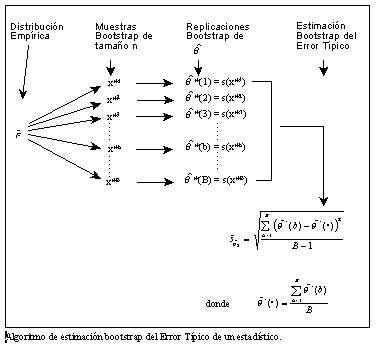
En cuanto al número de replicaciones necesarias para efectuar la estimación del error típico suelen considerarse suficientes 100 remuestras, variando el número indicado por los diferentes autores entre 50 y 200.
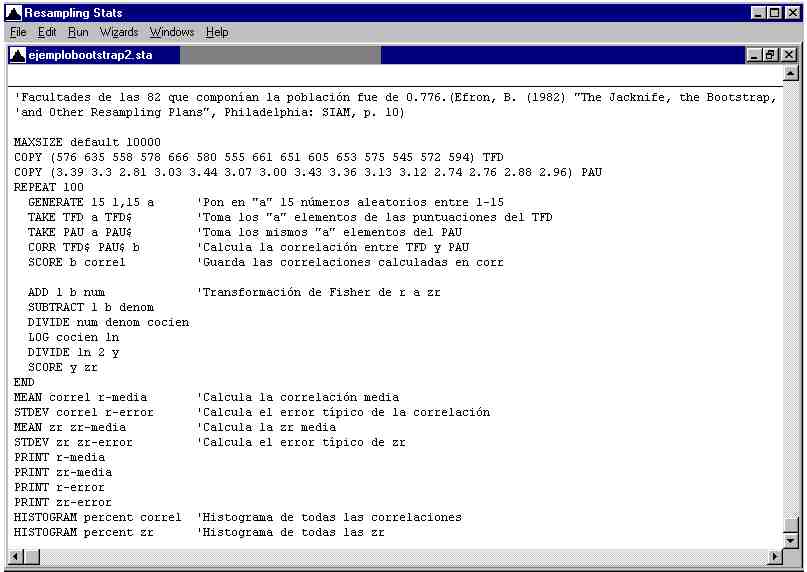
A modo de ejemplo emplearemos de nuevo la correlación
entre las puntuaciones en la PAU y la TFD. Para ello no tendremos más
que añadir al programa construido anteriormente una nueva instrucción
en la que se indique que calcule la desviación típica de
las estimaciones de la correlación calculadas sobre las B muestras
bootstrap generadas. Además hemos añadido los mismos
cálculos para la transformación de Fisher.
Los valores del error típico de ambos estadísticos de acuerdo a la aproximación clásica (suponiendo distribución normal) se calcularían con las expresiones:
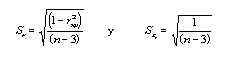
El programa con el algoritmo bootstrap se corrió
en nueve ocasiones para diferente número de remuestras, obteniéndose
los resultados de la siguiente tabla:
| B |
|
|
|
|
|
|
|
|
|
| Sr |
|
|
|
|
|
|
|
|
|
| Szr |
|
|
|
|
|
|
|
|
|
Dado que en este caso conocemos los datos del total de la población (las 82 universidades) podemos, empleando una simulación Monte Carlo en la que se extraen 15000 muestras aleatorias, calcular la distribución muestral de ambos estadísticos y sus correspondientes errores típicos para tomarlos como valores de referencia. En esta ocasión los valores fueron de 0'129 y 0'303 respectivamente.
Comparando con los valores de la tabla vemos que
hay una aproximación razonable incluso para un número de
remuestras moderado (entre 50 y 200) como el recomendado habitualmente
para la estimación bootstrap del error típico.