a partir de
 .
Las técnicas de simulación agrupadas
bajo el nombre genérico de bootstrap se ocupan de los mismos asuntos
que la estadística paramétrica pero bajo otro enfoque. Como
indican Efron y Tibshirani (1993) las
ideas básicas de la estadística no han cambiado lo que ha
cambiado es su implementación. La irrupción de los ordenadores
ha aportado rapidez y flexibilidad en la aplicación de ciertas ideas
hasta ahora aparcadas, permitiendo analizar aspectos no abordables con
facilidad analíticamente (Diaconis
y Efron, 1983).
La idea básica del bootstrap es tratar la muestra como si fuera la población, y aplicar el muestreo Monte Carlo para generar una estimación empírica de la distribución muestral del estadístico.
La verdadera estimación Monte Carlo requiere
un conocimiento total de la población, pero por supuesto este no
esta generalmente disponible en la investigación aplicada. Típicamente,
tenemos sólo una muestra extraída de esa población,
debido a lo cual es por lo que necesitamos, antes de nada, inferir
a partir de .
En el bootstrapping, tratamos la muestra como si
fuera la población y realizamos un procedimiento del estilo Monte
Carlo sobre la muestra. Esto se hace extrayendo un gran número de
"remuestras" de tamaño n de la muestra original aleatoriamente
y con reposición. Así, aunque cada remuestra tendrá
el mismo número de elementos que la muestra original, mediante el
remuestreo con reposición cada remuestra podría tener algunos
de los datos originales representados en ella más de una vez, y
algunos que no aparecieran. Por lo tanto, cada una de estas remuestras
probablemente será levemente y aleatoriamente diferente de la muestra
original. Y como los elementos en estas remuestras varían
levemente , un estadístico *,
calculado a partir de una de esas remuestras probablemente tomará
un valor ligeramente diferente de los otros *
y del
original . La afirmación fundamental del bootstrapping es que
una distribución de frecuencias relativas de esos *
calculada a partir de las remuestras es una estimación de la distribución
muestral de
(Mooney y Duval, 1993).
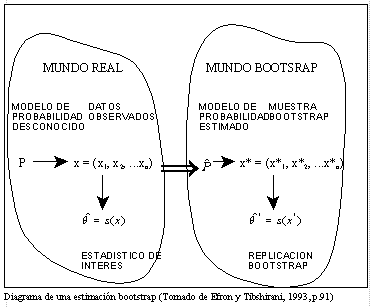
Más formalmente, los pasos básicos
en la estimación bootstrap son los siguientes Efron,
1979; Hinckley, 1988; Efron
y Tibshirani, 1993):
1.- Construir una
distribución de probabilidad empírica,  ,
a partir de la muestra asignando una probabilidad de 1/n a cada punto,
x1, x2, ..., xn. Esta es la función de distribución empírica
(FDE) de x, la cual es el estimador no-paramétrico de máxima
verosimilitud de la función de distribución de la población,
F(X).
2.- A partir de la FDE, ,
se extrae una muestra aleatoria simple de tamaño n con reposición.
Esta es una "remuestra", x*b.
3.- Se calcula el estadístico
de interés, ,
a partir de esa remuestra, dando *b.
4.- Se repiten los pasos
2 y 3 B veces, donde B es un número grande. La magnitud de B en
la práctica depende de las pruebas que se van a aplicar a los datos.
En general, B debería ser de entre 50 a 200 para estimar el error
típico de ,
y al menos de 1000 para estimar intervalos de confianza alrededor de
(Efron y Tibshirani, 1986, 1993).
5.- Construir una distribución
de probabilidad a partir de los B *b
asignando una probabilidad de 1/B a cada punto, *1, *2,
..., *B.
Esta distribución es la estimación bootstrap de la distribución
muestral de ,  . Esta distribución puede usarse para hacer inferencias sobre .
El estimador bootstrap del parámetro
se define como:
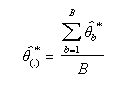
es decir, como la media de los valores del estadístico calculados en las B remuestras bootstrap.
En algunas ocasiones se tiene algún conocimiento más que el estrictamente aportado por la muestra, por ejemplo se conoce la función de distribución de la variable objeto de estudio pero se desconocen los parámetros, que deben ser estimados. En estos casos se estimarían los parámetros a partir de la muestra y el remuestreo se realizaría a partir de la función teórica conocida, con los parámetros estimados, en lugar de a partir de la FDE construida a partir de la muestra. En este caso hablamos de Bootstrap Paramétrico.
Para ejemplificar la aplicación de un procedimiento
bootstrap vamos a hacer uso de los datos ofrecidos por Efron
(1982, pág. 10) sobre la correlación entre las puntuaciones
medias de 15 universidades, de una población de 82, en una Prueba
de Acceso a la Universidad (PAU) y las puntuaciones de la prueba de admisión
en las Facultades de Derecho (TFD). La correlación encontrada en
esa muestra fue de 0'776. La correlación en la población
toma un valor de 0'76. En el desarrollo de los ejemplos se ha utilizado
el programa Resampling Stats (Versión 4, para Windows'95)
(Resampling Stats, Inc., 1998).
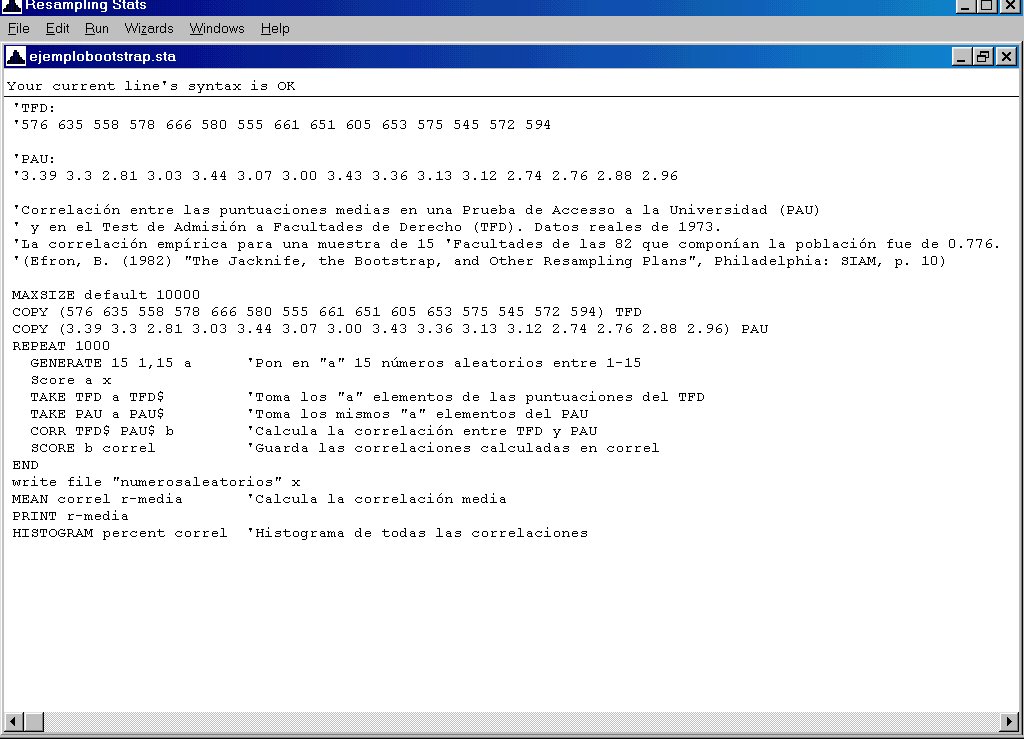
Al operar este procedimiento obtenemos los siguientes resultados que el estimador bootstrap de la correlación (r-media en el programa) vale 0'779 (Es obvio que este valor variará levemente cada vez que ejecutemos el programa, pues las remuestras generadas no coincidirán) . En la siguiente gráfica podemos ver la estimación bootstrap de la distribución muestral de la correlación.
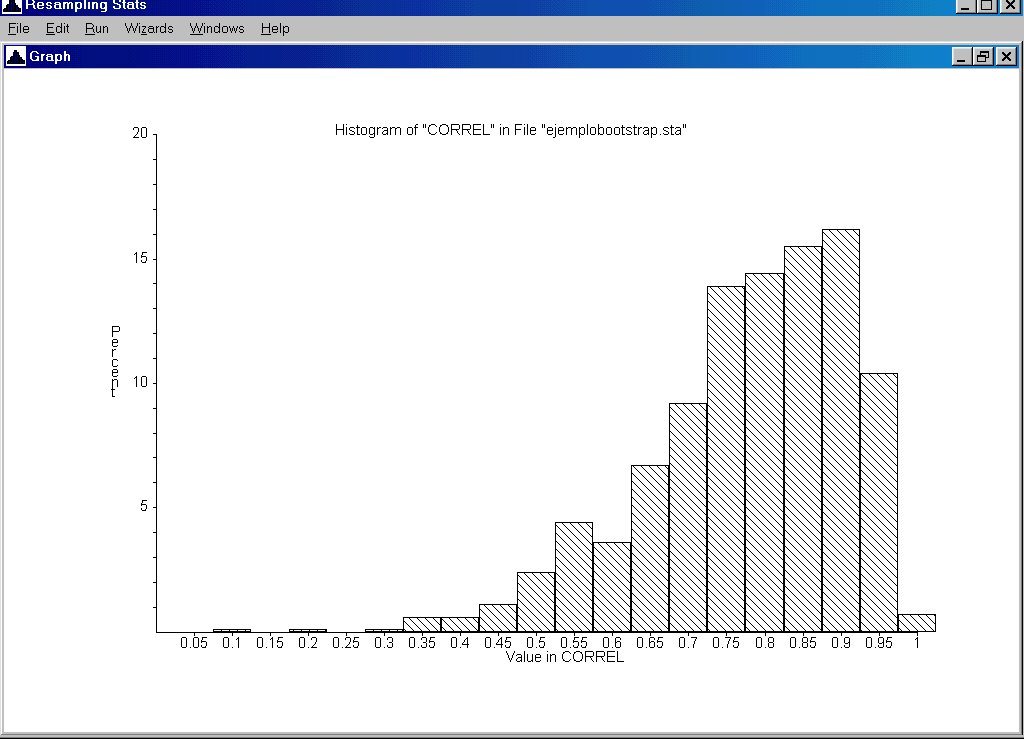
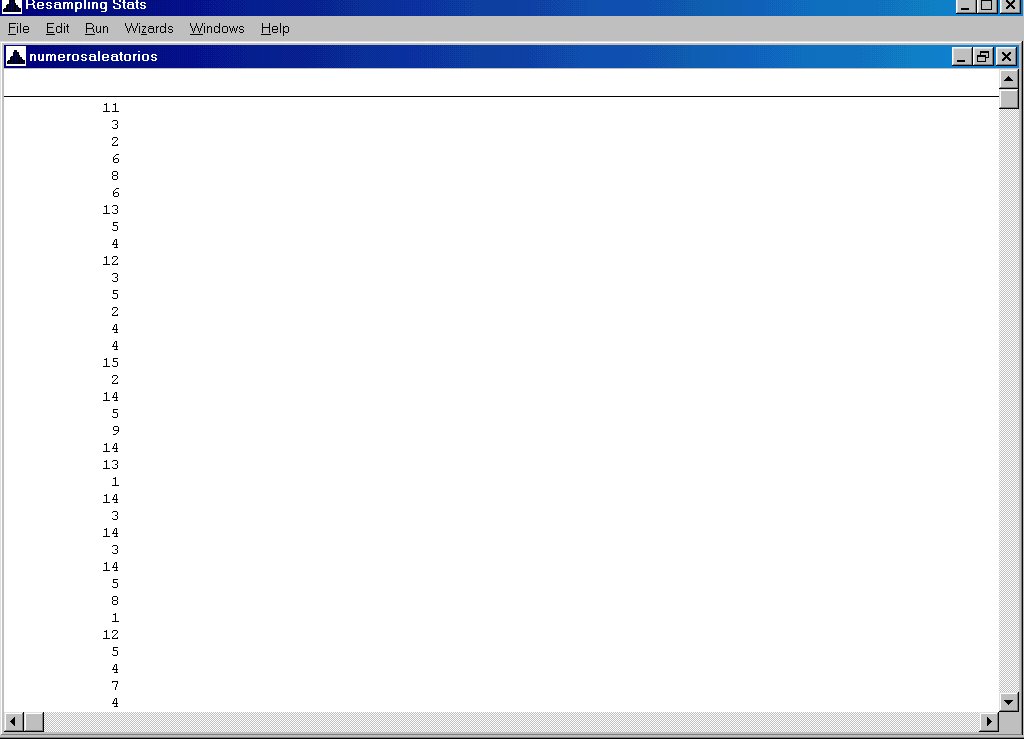
Además si consultamos el fichero "numerosaleatorios"
podremos comprobar los números empleados para seleccionar que elementos
de la muestra original entran a formar parte de cada una de las remuestras.
Cada secuencia de 15 números se corresponde con una remuestra. En
la gráfica se ofrece el inicio de la serie de números aleatorios
generados. Como puede verse en la primera secuencia de 15 números
algunos se repiten como el 3 (2), el 2 (2), el 6 (2), el 5 (2), el 4 (3)
y otros no aparecen como el 1, 7, 9, 10, 14 ó 15.